- はじめに
- 先に用語を固定します
- 結論から:これは「検証の積み木モデル」です
- 第1層:LLM単発推論 — 検証がない世界
- 第2層:ReAct — 「できたか」を自分で確認する
- 第3層:ループエンジニアリング — 合否判定を、作った本人の外に出す
- 第4層:グラフエンジニアリング — 目的適合の検証と、ループ同士の配線
- なぜ抽象度が上がっていくのか
- 自己流の判断基準
- まとめ
- 参考
はじめに
AIエージェント開発課のKazuki Kanekoです。
ここ数ヶ月、「ループエンジニアリング」や「グラフエンジニアリング」という言葉を見かけることが増えました。
- ループエンジニアリングは2026年6月に出てきた言葉
- グラフエンジニアリングは2026年7月に出てきた言葉
どちらも生まれて数ヶ月で、定義もまだ固まっていません。新しいワードが注目されると「ループの時代は終わったのか、これからはグラフか!」となりがちです。私も最初は、新しいのが出たので学んでみようというスタンスでした。
ただ、いろいろ触って考えた結果、今はこう捉えています。
ループとグラフは別物ではありません。「出力の品質を、誰が、どう検証するか」の抽象度を一段ずつ上げてきた、包含関係です。
この記事では、この捉え方を私なりに整理して共有します。
※この記事は2026年8月時点の、私の理解の整理です。厳密な系譜や歴史の解説ではありません。
先に用語を固定します
本題に入る前に、ひとつだけ注意点があります。
「グラフ」という言葉は、文脈によって指すものが違います。
- 実行制御のグラフ:LangGraphのように、エージェントの処理の流れをノードとエッジで設計するもの
- コンテキストのグラフ:GraphRAGのように、LLMに渡す知識をグラフ構造で持つもの
この2つは別レイヤーの話ですが、どちらも「グラフ」と呼ばれるので混ざりがちです。この記事で扱うのは前者(実行制御のグラフ)です。
結論から:これは「検証の積み木モデル」です
先に結論の図を出します。

ループエンジニアリングの中では、ReActループが回っています。グラフエンジニアリングの中では、ループエンジニアリングで組んだループが回っています。外側の層は内側の層を置き換えるのではなく、包んでいるだけです。
では、層が上がるごとに何が変わっているのか。私は「検証」に注目すると一番すっきり整理できると思っています。
| 層 | 検証されるもの | 合否を判定する主体 | 人間から引き継いだ役割 |
|---|---|---|---|
| 第1層 LLM単発推論 | 出力そのまま | 人間(仕組みの外) | — |
| 第2層 ReAct | タスクが完了したか | LLM自身(自己申告) | 「次に何をするか」を決める作業者 |
| 第3層 ループエンジニアリング | 1つの成果物が、事前に決めた合格基準を満たしているか | 実行した本人とは別の判定器(テスト / Lint / スキーマ、または評価用LLM) | ログを読んでNG理由を伝えるレビュアー |
| 第4層 グラフエンジニアリング | 複数の成果物が互いに整合し、本来の目的に沿っているか | 合流点に置いた上位の判断(強いモデル or 人間) | 複数の作業を調停するマネージャー |
つまり各層がやっているのは、それまで人間が担っていた検証の役割を、一段ずつ仕組みに肩代わりさせることです。第1層では検証の仕組みが一切なく、判定主体は仕組みの外にいる人間でした。 ここから、各層を順に見ていきます。
なお、この記事の図は色を統一しています。
- 🟦 青:LLMが動くノード(推論・エージェント実行)
- 🟩 緑:検証・分岐・人間の承認(品質を担保するポイント)
- ⬜ グレー:入出力・外部リソース
同じ色を追っていくと、外側の層に行くほど緑(検証)の比重が増えていくのが見えると思います。
第1層:LLM単発推論 — 検証がない世界
出発点はここです。LLMに1回プロンプトを投げて、1回答えが返ってくる。
- 良いプロンプトを書く(プロンプトエンジニアリング)
- 良い文脈を渡す(RAG、のちのコンテキストエンジニアリング)
工夫のしどころは「入力」でした。
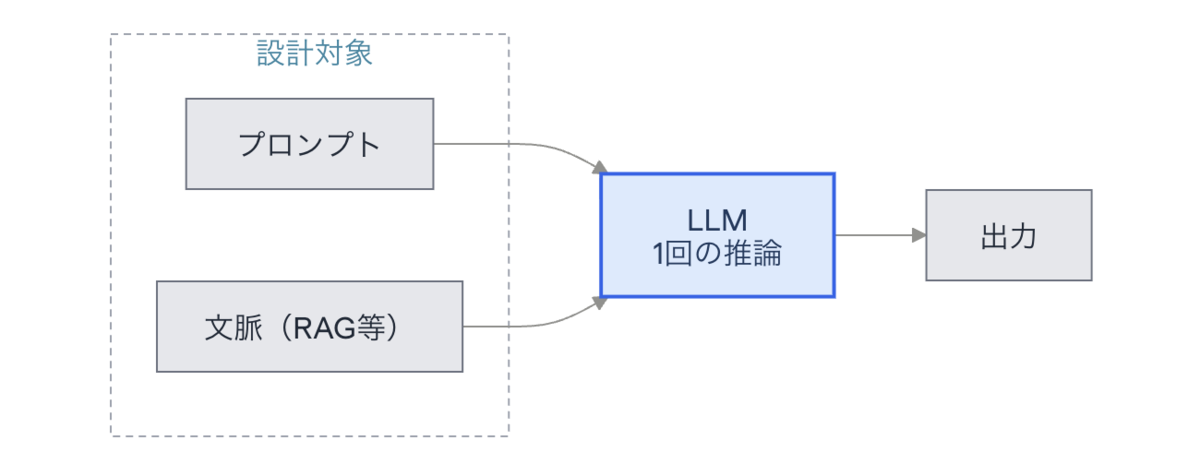
この図に緑(検証)のノードは1つもありません。出力が正しいかどうかを確かめるのは、100%人間の仕事です。出てきたものを人間が読んで、ダメなら人間がプロンプトを直して投げ直す。検証と再実行のループを、人間が手で回していた、とも言えます。
第2層:ReAct — 「できたか」を自分で確認する
考える → ツールを使う → 結果を見る → また考えるを繰り返す形。いわゆるReActパターンです。

第1層との決定的な違いは、緑のノードが初めて登場したことです。「タスクは完了したか?」という検証を、LLMが自分でやるようになりました。人間が担っていた「次に何をするか決めて、できたか確認する」という作業者の役割が、ループの中に取り込まれたわけです。
Claude CodeやDevinのようなコーディングエージェントの「エージェントらしさ」も、中心にあるのはこのループです。
ただし、ここでの検証には弱点があります。自己申告だということです。「完了したか?」を判定しているのは、その出力を作った本人(LLM)です。テストを書かずに「動きました」と言ってくるエージェントを見たことがある人なら、この検証だけでは品質を担保しきれないことを体感していると思います。
第3層:ループエンジニアリング — 合否判定を、作った本人の外に出す
そこで出てくるのが、2026年6月にGoogleのAddy Osmani氏が広めた「Loop Engineering」です。
Osmani氏の整理では、ループエンジニアリングとは「仕事を発見し、エージェントに配り、結果を検証し、進捗を記録し、次の仕事を決めるシステム」の設計です。
私の言葉で言い直すと、こうなります。
第2層の自己申告を信用せず、合否判定を「それを作った本人の外」に出す層です。テストやLintのような決定的な判定器が典型ですが、ルーブリックを渡した評価用LLMに採点させるのも同じ構造です。重要なのは判定器が機械かどうかではなく、出力した本人が自分で合格を宣言していないことです。

図の真ん中に、第2層のReActループが青いノードとしてまるごと入っていることに注目してください。ループエンジニアリングはReActを置き換えていません。包んで、外側に検証と再実行の仕組みを足しているだけです。
これ、人間がやってた作業ですよね
この層が肩代わりしているのは「レビュアー」の役割です。
たとえば、エージェントが出力したコードが失敗したとき、私はAWSのCloudWatchのログを見に行って、「これがNGの理由っぽいですよ」とエラーログをエージェントに貼り付けて再実行させる、という作業をよくやっていました。
ループエンジニアリングの「Fail → 失敗ログをフィードバックとして次の入力に含めて再実行」は、まさにこの人間の作業をモデル化したものだと捉えています。
- 合否の判定:人間が目で見る → テスト / Lint / スキーマ検証が機械的に判定する
- NG理由の伝達:人間がログをコピペする → 失敗ログを自動でコンテキストに含める
- 再実行の判断:人間が「もう一回やって」と言う → 停止条件(試行回数・予算)の範囲で自動リトライ
エージェントの賢さに期待するのではなく、検証と再実行の仕組みで品質を担保する。モデルが十分賢くなったからこそ、「中の推論」より「外側の回し方」が差別化要因になった、とも言えます。
ただし、1つの成果物の中では判定できないものがある
第3層の検証は強力ですが、判定できるのはそのループが作った1つの成果物の中で閉じる問いだけです。
「この実装方針で良かったのか?」なら、まだ第3層で戦えます。判定器を強いモデルに変えて、設計方針をレビューさせればいい。機械的な基準に落ちないこと自体は、第3層を降りる理由になりません。
第3層で本当に手が出ないのは、複数のループの成果物をまたぐ問いです。
- 実装ループの出力とドキュメントループの出力が、食い違っていないか
- 個々のタスクは全部Passしたのに、束ねたら当初の目的からずれていないか
これらは、どちらか一方のループの中からは見えません。判定を下すには、複数の成果物が合流した地点が要ります。その合流点を作る層が第4層です。
第4層:グラフエンジニアリング — 目的適合の検証と、ループ同士の配線
2026年7月頃から「ループの次はグラフでは?」という議論が始まりました。きっかけはPeter Steinberger氏の「Are we still talking loops or did we shift to graphs yet?(まだループの話してる?それとももうグラフに移った?)」というポストと言われています。当時私もこのポストを見て「グラフってなんだ?」と疑問を抱いた記憶があります。
私はグラフの関心事を、2つに分けて捉えています。
1つ目は、合流点でしかできない検証です。 複数のループの出力を1か所に集めて、互いに整合しているか、束ねた結果が本来の目的に沿っているかをレビューする。判定するのは相当賢いモデルか、承認ノードとして入る人間です。第3層と違うのは判定器の賢さではなく、判定に必要な材料が1つのループの中に揃わないという点です。
2つ目は、配線です。 ループが複数になると、実行順序・依存関係・失敗時の戻り先を明示的に設計しないと破綻します。たとえば「実装ループが終了しないと、テストループは動き出せない。テストループは実装ループの成果物を受け取る」という依存関係。あるいは「検証NGだったら、どのノードまで戻すのか」という戻り先。この配線図がグラフです。冒頭で触れたLangGraphは、まさにこの配線(ノード・エッジ・共有状態)を実装するためのフレームワークで、Google ADKやMicrosoftのAgent Frameworkにも同様の仕組みがあります。

ここでも注目してほしいのは、青いノード「ループA」「ループB」の中身が第3層で設計したループそのものだということです。グラフはループを置き換えていません。第3層で品質担保されたループを部品として、その外側に「合流」「目的適合の検証」「戻り先」を配線しているだけです。
そして、失敗系のエッジ(自動検証NG、人間の差し戻し、例外)がすべて計画ノードに戻っていることも、この層の性格をよく表しています。第3層のFailは「同じタスクをログ付きでリトライ」でしたが、第4層のFailは「そもそも計画からやり直す」。検証の抽象度が上がると、差し戻しの抽象度も上がるわけです。
なぜ抽象度が上がっていくのか
ここまでを振り返ると、層が積み上がる理由が見えてきます。
- 第1層には検証がなく、品質担保は100%人間の仕事だった
- 第2層で「完了したか」の検証をLLMに任せた。ただし自己申告なので信用しきれない
- 第3層で合否判定を、作った本人の外に出した。ただし1つの成果物の中で閉じる問いしか判定できない
- 第4層で、複数の成果物をまたぐ検証を、合流点に置いた上位の判断(強いモデル or 人間)に任せた
つまり、今の検証手段では判定できないものが現れるたびに、一段外側の検証層が生まれている。これが、私がこの積み重なりの軸を「検証の抽象度」とした理由です。
そしてどの段も、やっていることの本質は同じです。人間が担っていた検証の役割を、仕組みに肩代わりさせる。 作業者(第2層)、レビュアー(第3層)、マネージャー(第4層)と、置き換える役割の抽象度が上がってきただけです。
自己流の判断基準
この層の見方に立つと、「どのアーキテクチャを選ぶか」は「どの層まで登る必要があるか」という問いに変換できます。私が使っている判断基準を、まずフローチャートで示します。
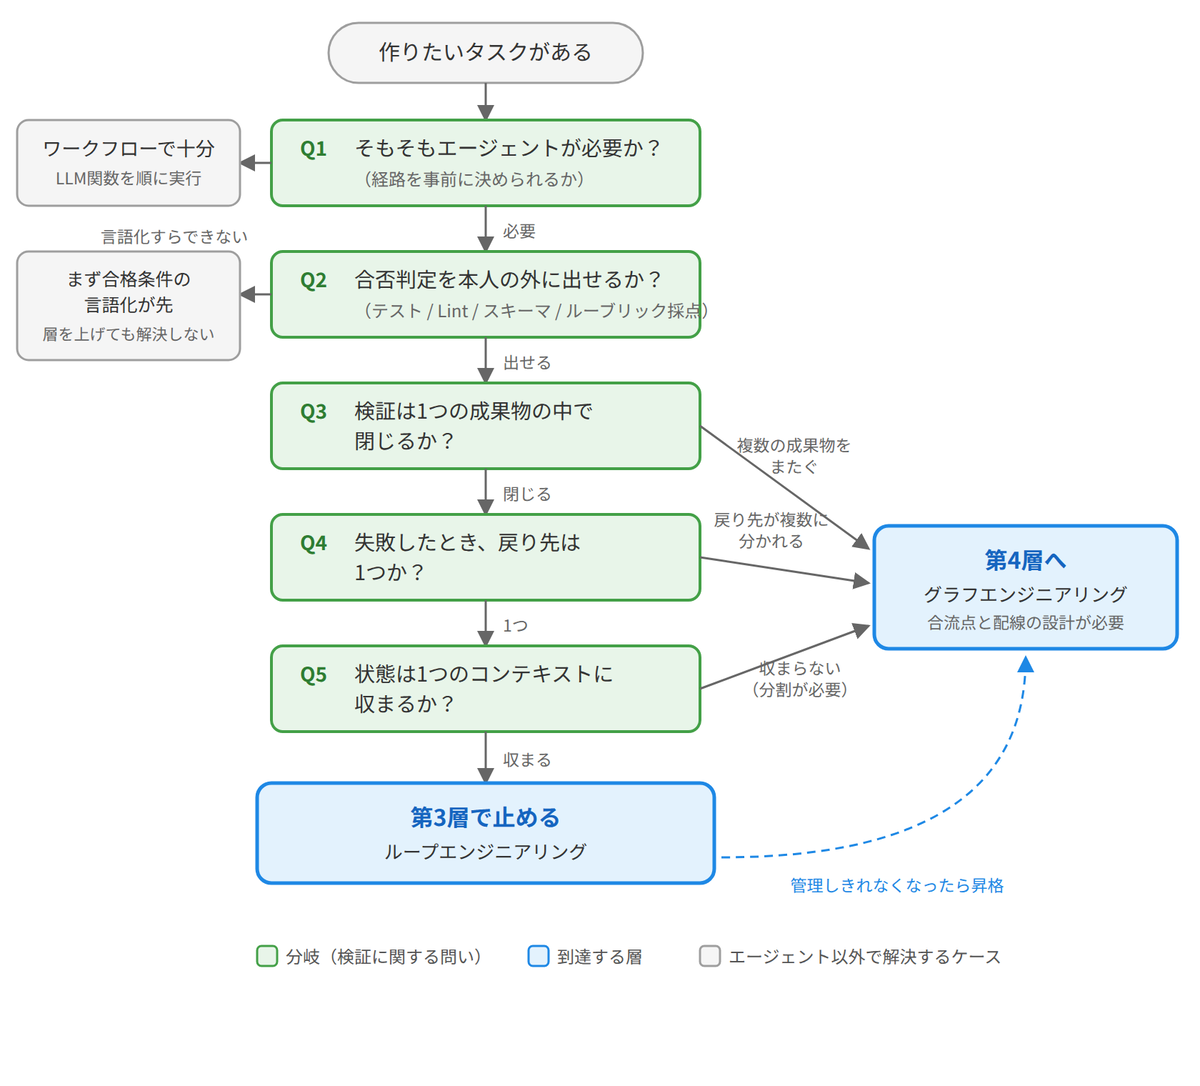
以下、Q1から順に補足していきます。
Q1. そもそもエージェントが必要か?
経路が完全に事前に決められるなら、LLMを呼ぶ関数を順番に実行するだけのワークフローで十分です。安く、速く、確実です。→ 必要なら Q2 へ。
Q2. 合否判定を、作った本人の外に出せるか?
テスト、Lint、スキーマ検証で判定できるなら、そのまま第3層です。機械的な基準に落ちない場合でも、合格条件をルーブリックとして書き出せて、別のモデルに採点させられるなら、これも第3層です。ここで第4層に飛ぶ必要はありません。
逆に、合格条件を言語化すらできず、毎回人間が現物を見ないと判断できないなら、それは層を上げて解決する問題ではありません。まずは合格条件を言語化する作業のほうが先です。→ Q3 へ。
Q3. その検証は、1つの成果物の中で閉じるか?
閉じるなら第3層のままでいけます。実装とドキュメントの整合、複数タスクの成果を束ねた後の目的適合など、複数の出力を突き合わせないと判定できないなら、合流点が必要になるので第4層です。→ Q4 へ。
Q4. 失敗したとき、戻り先は1つか?
「同じタスクを、失敗ログを添えてやり直す」だけで済むなら第3層で十分です。停止条件を超えたときのエスカレーション先が人間になるのは第3層でも普通で、これは層を上げる理由になりません。
一方、「これは実装からやり直し、これは計画からやり直し」と戻り先が複数に分かれるなら、どこへ戻すかを明示的に描く必要があります。その戻り先の一覧がグラフです。→ Q5 へ。
Q5. 状態は1つのコンテキストに収まるか?
タスクが長く、複数の専門性が必要で、1つのコンテキストで持ちきれないなら、複数のループへの分割を検討します。ただし、分割した瞬間に依存関係と戻り先の設計、つまり配線が必要になるので、これも第4層のグラフが必要になります。
Q3・Q4・Q5がすべてYesなら、第3層で止めてください。これが推奨の初期形です。 むしろ多くのタスクは、Q2をYesで抜けた時点で完成します。
ポイントは、グラフが最新だから、グラフにしようとならないことです。
上の段は、下の段の検証では管理しきれなくなった複雑さを整理するための道具です。その複雑さがまだ無いのに導入すると、設計コストだけ払うことになります。
第3層のループで始めて、管理しきれなくなったら第4層に昇格させる。これが今のところ私の結論です。
まとめ
- ループエンジニアリングとグラフエンジニアリングは別物ではなく、包含関係です
- 各層がやっているのは、人間が担っていた検証の役割(作業者→レビュアー→マネージャー)を仕組みに肩代わりさせることです
- 今の検証手段で判定できないものが現れるたびに、一段外側の検証層が生まれます
- 選び方は「どの層まで必要か」。判定を本人の外に出せて、その判定が1つの成果物で閉じるならループ。複数の成果物を突き合わせる必要があるか、失敗時の戻り先が複数に分かれるならグラフです
- そして、いきなりグラフから始めない。ループで始めて、必要になったら昇格させます
この分野は数週間単位で前提が変わります。この記事の整理も、半年後には自分でアップデートしている気がします。そのときはまた、整理し直した記事を書こうと思います。
最後に、この記事の立ち位置を書いておきます。世間の「グラフエンジニアリング」の議論は、複数のエージェントを並列に動かすマルチエージェント組織の設計、という切り口で語られることが多い印象です。この記事の「検証の抽象度」という軸は、それとは別の切り口です。どちらが正しいという話ではなく、定義がまだ固まっていない言葉だからこそ、自分の設計判断に使える形で捉え直してみた、というのがこの記事です。
実際、私はこの捉え方を「新しいアーキテクチャを追いかけるための地図」ではなく、「いま作っているものは、どの層の検証で品質を担保できるか」を問うための、設計判断の1つの軸として使っています。
自分の整理も兼ねて、記事を執筆しました。ループとグラフを語る上での一つの軸として持ち帰って頂ければ幸いです。
参考
- Addy Osmani, "Loop Engineering: Designing loops that prompt coding agents"(2026年6月8日) https://addyo.substack.com/p/loop-engineering (O'Reilly Radar転載版:https://www.oreilly.com/radar/loop-engineering/)
- Peter Steinberger氏のポスト(2026年7月18日) https://x.com/steipete/status/2078277297791189132
- Yao et al., "ReAct: Synergizing Reasoning and Acting in Language Models"(2022年) https://arxiv.org/abs/2210.03629
