こんにちは!楽楽精算開発部 の yamaguchi877 です。
「保守開発チーム」と聞くと、障害発生時の地道な調査やお客様からの問い合わせ対応に追われる姿を想像される方が多いかもしれません。 ですが私たちのチームでは問い合わせの切り分けと一次調査をAIエージェントに任せる仕組みを構築・運用し始めています。
本記事では、その仕組みづくりで直面した 「AIの判定を毎回同じにするにはどうすればいいのか」 という壁を紹介しつつ、 私たちなりの答え(固定ルーブリック+回帰テストという設計)とあわせて、構想から運用までの試行錯誤をご紹介します。
- 抱えていた課題 — 問い合わせ対応と開発時間の綱引き
- 全体像 — 楽楽販売からGitHub Issues、そしてAIエージェントへ
- 最大の壁 — AIの判定は「毎回同じ」にできるのか
- エージェントは分業制 — そして無理な自動化はしない
- AIがAIのルールを改善する — ただしガードレール付きで
- つまずきポイント — GitHub Actionsのifでハマった話
- これから — 完全自律型エージェントへの道
- 最後に
抱えていた課題 — 問い合わせ対応と開発時間の綱引き
私たち保守開発チームは、主に以下の4つをメインタスクとして日々を過ごしています。
- お客様からの問い合わせ対応
- 外部連携システムのアップデート対応
- 楽楽精算内部の不具合対応
- 他チームへの知見共有
このうち一番迅速性が求められるのが、お客様からの問い合わせ対応です。
問い合わせは、CSが社内の管理システム(楽楽販売)に起票し、エンジニアが内容を切り分けて調査・回答する流れで届きます。
種類の見極め、類似事例の確認、ログや設定の調査——1件ずつは小さくても、積み重なれば調査工数は膨らみ、開発に充てる時間を圧迫します。
さらに、問い合わせ対応の体制見直しにより、エンジニアが受け持つ問い合わせの範囲は今後さらに広がる見込みでした。
何も手を打たなければ、開発時間が削られるのは目に見えていました。
この「工数増」を打ち消す切り札が、問い合わせの切り分けと初期調査をAIエージェントに任せる仕組みです。
切り分け・初期調査をAIで即時に走らせ、エンジニアは判断と最終確認に集中する。
そうしてお客様への回答リードタイムを短縮する——これがこの取り組みで狙う顧客価値です。
全体像 — 楽楽販売からGitHub Issues、そしてAIエージェントへ
仕組みの全体像はこうです。
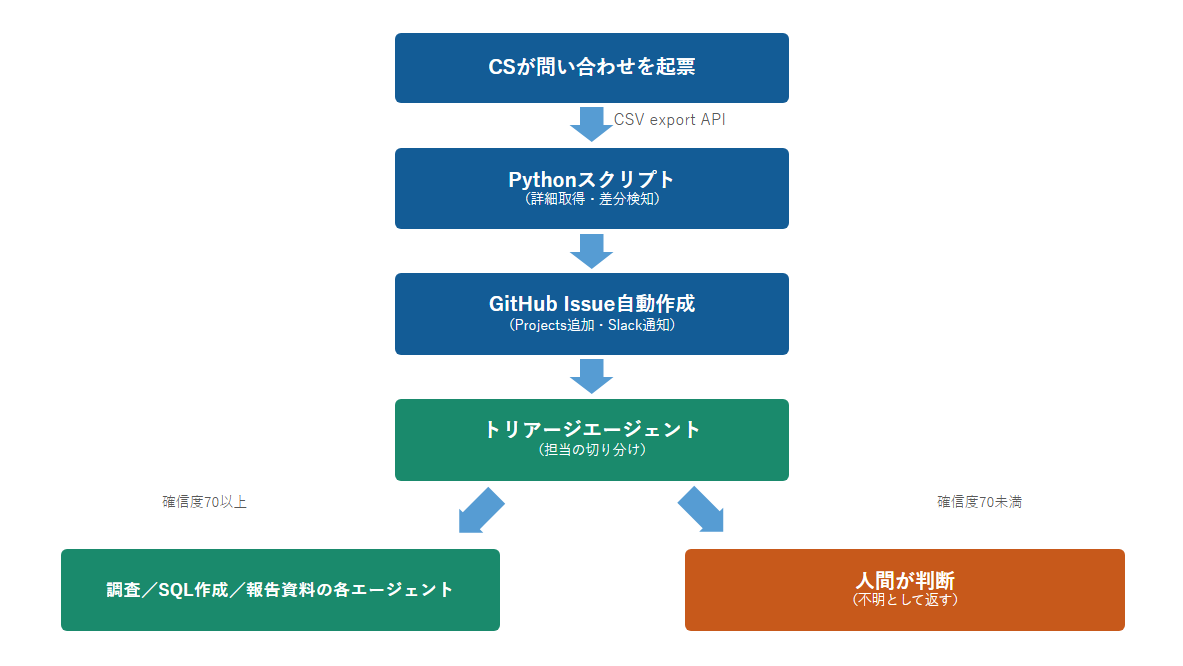
起票部分は完全に固定作業になるためPythonのスクリプトにしています。
今はこの部分からAIに任せてしまうことも考えられますが、今後はAIによるトークン消費のコスト意識も必要になると考え、固定作業はスクリプトにしています。
AIによる最大のメリットを享受するためには、「何をAIに任せるか」の線引きも大事だと感じています。
最大の壁 — AIの判定は「毎回同じ」にできるのか
トリアージとは、Issueを読んで「誰が調査すべきか」をラベル(仕様・不具合調査/環境構築/クレジットカード関係/不明など)で切り分ける作業です。
AIに任せるにあたり、最初は素朴に「Issueを読んで適切なラベルを付けて」とAIの裁量に任せるプロンプトを書いていましたが、実行するたびに判定が微妙にブレていました。
試行錯誤の末にたどり着いたのが、AIの裁量を徹底的に排除するという方向性でした。
具体的には分類ルールを次の形式で記述しています。
| 分類ルール | 内容 | 狙い |
|---|---|---|
| 順序固定の判定手順 | Step 1:「このIssueの主目的は『◯◯してほしい』だ」と一文に要約する Step 2:クレジットカード判定 Step 3:環境構築判定 → … 必ずこの順番で実行させ、途中のStepを飛ばさせない |
判定の経路を毎回同じにする |
| トリガー語句の表 | 「構築してほしい」「原因を知りたい」など、 判定の決め手になる語句を表で列挙し、表への一致で判定させる |
言い回しの解釈をブレさせない |
| 固定の確信度ルーブリック | 確信度は85/70/50/40/30の5値のみ 70以上でラベル付与、70未満は「不明」として人間に返す |
確信度の数値をブレさせない |
たとえばこんなトラップ事例があります。
「〇〇の連携の不具合に伴う環境構築依頼」
上記のような題名のIssueがあった時、主目的は環境構築なのに、「不具合」の文言に引っ張られ、モデルによっては「仕様・不具合調査」へ誤分類されていました。
分類ルールを通せば、Step 1で主目的が「構築」と確定し、「不具合」は背景の語句として扱われます。
その結果、モデルや実行タイミングに左右されず、「環境構築・インフラとのやりとり」に機械的に決まるようになりました。
「ここまでルールを固定するなら、ただのif文でなんとかなるのでは?」と思われるかもしれません。 ですが、無限にある言い回しをif文で網羅するのは現実的ではありません。かといって、判断基準そのものはAIに委ねない。
ルールを記述・保守するのは人間、言い回しの揺れを吸収してルールに当てはめるのはAI
この分担が肝となりました。
回帰テストでプロンプトを守る
そしてもうひとつ、個人的に一番の学びだったのがこれです。
プロンプトも、コードと同じように回帰テストで守ることができる。
分類ルールを変更したら、過去の確定事例を集めた事例集に対してテストモードで再判定を走らせます。
全件一致を確認してから、変更を確定する運用にしています。コードのリファクタリングでテストを回すのと同じ感覚です。
これを始めてから、「ルールを直したら別のケースが壊れた」という事故を未然に防ぐことができるようになりました。
また、GitHub Actionsで動く自動経路のモデルもコストと再現性のため固定しています。
エージェントは分業制 — そして無理な自動化はしない
エージェントは、人間のチームと同じ「分業制」にしています。1人の万能選手を作って回すのではなく、役割を絞った担当を連携させ、個々の精度を上げる。
そして手戻りを減らし、業務全体を安定して速く回すことを第一目標としているためです。
| エージェント | 役割 |
|---|---|
| トリアージ担当 | Issueを読み、依頼種別と後続エージェントを判断する |
| 調査担当 | アプリ仕様・DB定義・過去依頼を調査し、根拠と未確認事項を整理する |
| SQL作成担当 | 確認用・実行用SQLとレビュー観点を作成する |
| SQL稼働確認担当 | 作成されたクエリのレビューと稼働確認までを自動で実施する |
| 報告資料担当 | 調査結果やSQLを統合し、報告用Markdownにまとめる |
エージェントを分けたことによるメリットは、大きく3つあります。
- それぞれのエージェントに渡す指示とコンテキストを小さく保てること
- 間違えたときに「どこで間違えたか」がすぐ分かること
- 工程の間に人間が介入できるポイントが生まれること
確信度70未満を「不明」として人間に返す設計も同じ思想です。
自信を持って判定できるものだけAIに捌かせ、迷うものは人間が判断する。そして人間が付けた正解ラベルは、AIの判断基準を改善する材料として蓄積させることができます。
AIがAIのルールを改善する — ただしガードレール付きで
上記のような運用を続けると、AIの自動判定と人間が最終的に付け直したラベルの間にズレが蓄積していきます。
このずれを取り込むための「最適化エージェント」も用意しています。判定履歴と人間の最終ラベルを突き合わせて誤分類のパターンを分析し、分類ルールと事例集の改善案を作ります。AIがAIのルールを改善するループです。
ただし、ここにも三重のガードレールを敷いています。
- エージェントが直接適用できるのは事例集への追記のみ
- 分類ルール本体の最終変更は回帰テスト合格後にのみ適用
- 不要になった事例の削除は人間の判断で行う
「AIによる自己改善」は聞こえがいいですが、無条件に回すとルールが静かに壊れていくリスクがあります。
改善のループは回しつつ、確定の権限は人間と回帰テストが握る。このバランスが現時点での私たちの落としどころです。
つまずきポイント — GitHub Actionsのifでハマった話
最後に、恥ずかしい失敗談をひとつ。
Issueへのラベル付与をトリガーに自動トリアージを起動するworkflowで、誤爆防止のガードをこう書いていました。
if: github.event.label.name == env.ENGINEER_REQUEST_LABEL
一見動きそうですよね。ところがこのガード、一度もマッチしませんでした。GitHub Actionsの仕様で、jobレベルのifではenvコンテキストが参照できません(使えるのはgithub/needs/vars/inputsのみ)。
そのためenv.ENGINEER_REQUEST_LABELが空文字に評価され、常にfalseになっていたのです。
原因究明の末、ラベル名はリテラルで直接書く形に落ち着きました。
if: >-
  github.event_name == 'workflow_dispatch' ||
  github.event.action != 'labeled' ||
  github.event.label.name == 'エンジニア依頼'
AIでなんでも書けている気になって、基礎も押さえず実装していたため、「なぜか自動起動しない」を追いかけた時間は、なかなかのものになってしまいました。同じ轍を踏む方が一人でも減れば幸いです。
これから — 完全自律型エージェントへの道
現在、トリアージの自動実行は試験運用中で、日々小さな更新を行っています。
依頼を検知してから報告までの自動化を最終目標に、段階的な移行を進めており、トリアージの先の各パートでも、チームメンバーがそれぞれ検討を進めています。
以下、検証のざっくりした方針です。
- 仕様・不具合調査の精度向上
- Issueを読み取り、ソースコードを元に原因の一次調査を行う
- 原因箇所と発生条件を調査レポートとして生成し、ユーザーに通知
- 必要であればクエリ自動作成に繋げる
- クエリ自動生成の高度化
- 顧客調査が必要な問い合わせに対し、クエリ作成を行う
- SELECT系クエリ、UPDATE系クエリごとにPRを作成するリポジトリを選択
- 自動でクエリ稼働確認に繋げる
- クエリ稼働確認の自動化
- テスト対象クエリに対し、クエリの記述ミスや不整合を検出するためのテストデータを自動生成
- 検証環境へ自動接続し、対象クエリの配置およびテストデータの展開を実施
- クエリを自動実行し、実行結果を収集・フィードバック
最後に
保守開発チームの仕事は、派手さはないかもしれません。
ですが今回取り組んだ問い合わせ対応の原点は、「お客様の困りごとに、早く正確に答える」ことです。
そこに立ち返ると、AIエージェントの活用はこれ以上ないほど相性の良い挑戦だと感じています。
ラクスの開発本部は「AIネイティブな開発組織」への変革を進めています。
この取り組みもその一環で、AIを前提に業務フローそのものを再設計する挑戦だと捉えています。
同じように問い合わせ対応の工数に悩むチームの、何かのヒントになれば嬉しいです。最後までお読みいただきありがとうございました!
